La plupart des comparatifs de détecteurs IA ont un an de retard sur les modèles qu’ils sont censés démasquer. Nous avons donc constitué un corpus neuf : 522 textes en anglais, 177 512 mots, dont 251 écrits par des humains et 271 générés par des LLM actuels et de la génération précédente. Le 27 août 2026, nous l’avons soumis en entier à GPTZero, ZeroGPT et à notre propre détecteur, tropa-2.
Un verdict par détecteur et par texte. Chaque texte et chaque score sont publics : vous pouvez vérifier n’importe quel chiffre ci-dessous.
L’essentiel
- Les modèles actuels passent entre les mailles de la plupart des détecteurs. Sur du texte brut de GPT-5.6, Claude Opus 5 / Fable 5, Gemini 3.6, Grok 4.6 et consorts (n = 136), GPTZero a classé 41,9 % comme IA, ZeroGPT 11,8 %, tropa-2 96,3 %.
- Les modèles de l’an dernier sont un problème réglé : GPTZero 100 %, ZeroGPT 90 %, tropa-2 100 %. La difficulté de détection dépend presque entièrement de l’âge du modèle.
- Faux positifs : sur 251 textes humains, GPTZero n’en a accusé aucun, tropa-2 un seul (0,4 %), ZeroGPT sept (2,8 %).
- La paraphrase est le cas difficile pour tout le monde : quand un modèle actuel réécrit un texte humain, GPTZero en repère 2,0 %, ZeroGPT 2,1 %, tropa-2 74,0 %.
- Une mise en garde avant toute citation : les textes IA proviennent de notre propre chaîne de génération ; ce corpus est donc plus proche de la distribution d’entraînement de tropa-2 que de celle de GPTZero ou de ZeroGPT.
Les résultats
Part des textes classés IA par chaque détecteur. Pour la ligne humaine, il s’agit du taux de faux positifs (plus il est bas, mieux c’est) ; pour les autres, du taux de détection (plus il est haut, mieux c’est). ZeroGPT n’a rien renvoyé pour 3 textes : sa colonne porte donc sur 519.
| Catégorie | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| Humain (faux positifs) | 251 | 0,0 % | 2,8 % | 0,4 % |
| IA, total | 271 | 47,2 % | 23,4 % | 93,4 % |
| Modèles actuels, brut | 136 | 41,9 % | 11,8 % | 96,3 % |
| Modèles actuels, paraphrase | 50 | 2,0 % | 2,1 % | 74,0 % |
| Modèles précédents, brut | 50 | 100 % | 90,0 % | 100 % |
| Modèles précédents, paraphrase | 35 | 57,1 % | 2,9 % | 100 % |
Les deux dernières lignes comparées aux deux du milieu disent tout. Il suffit de monter d’une génération de modèles pour que GPTZero tombe de 100 % à 41,9 % et ZeroGPT de 90 % à 11,8 %.
Modèle par modèle : qui se fait repérer
Sortie brute, non paraphrasée, des modèles actuels. Le n par modèle est faible (de 1 à 18 textes) : chaque ligne donne une tendance, pas une mesure précise.
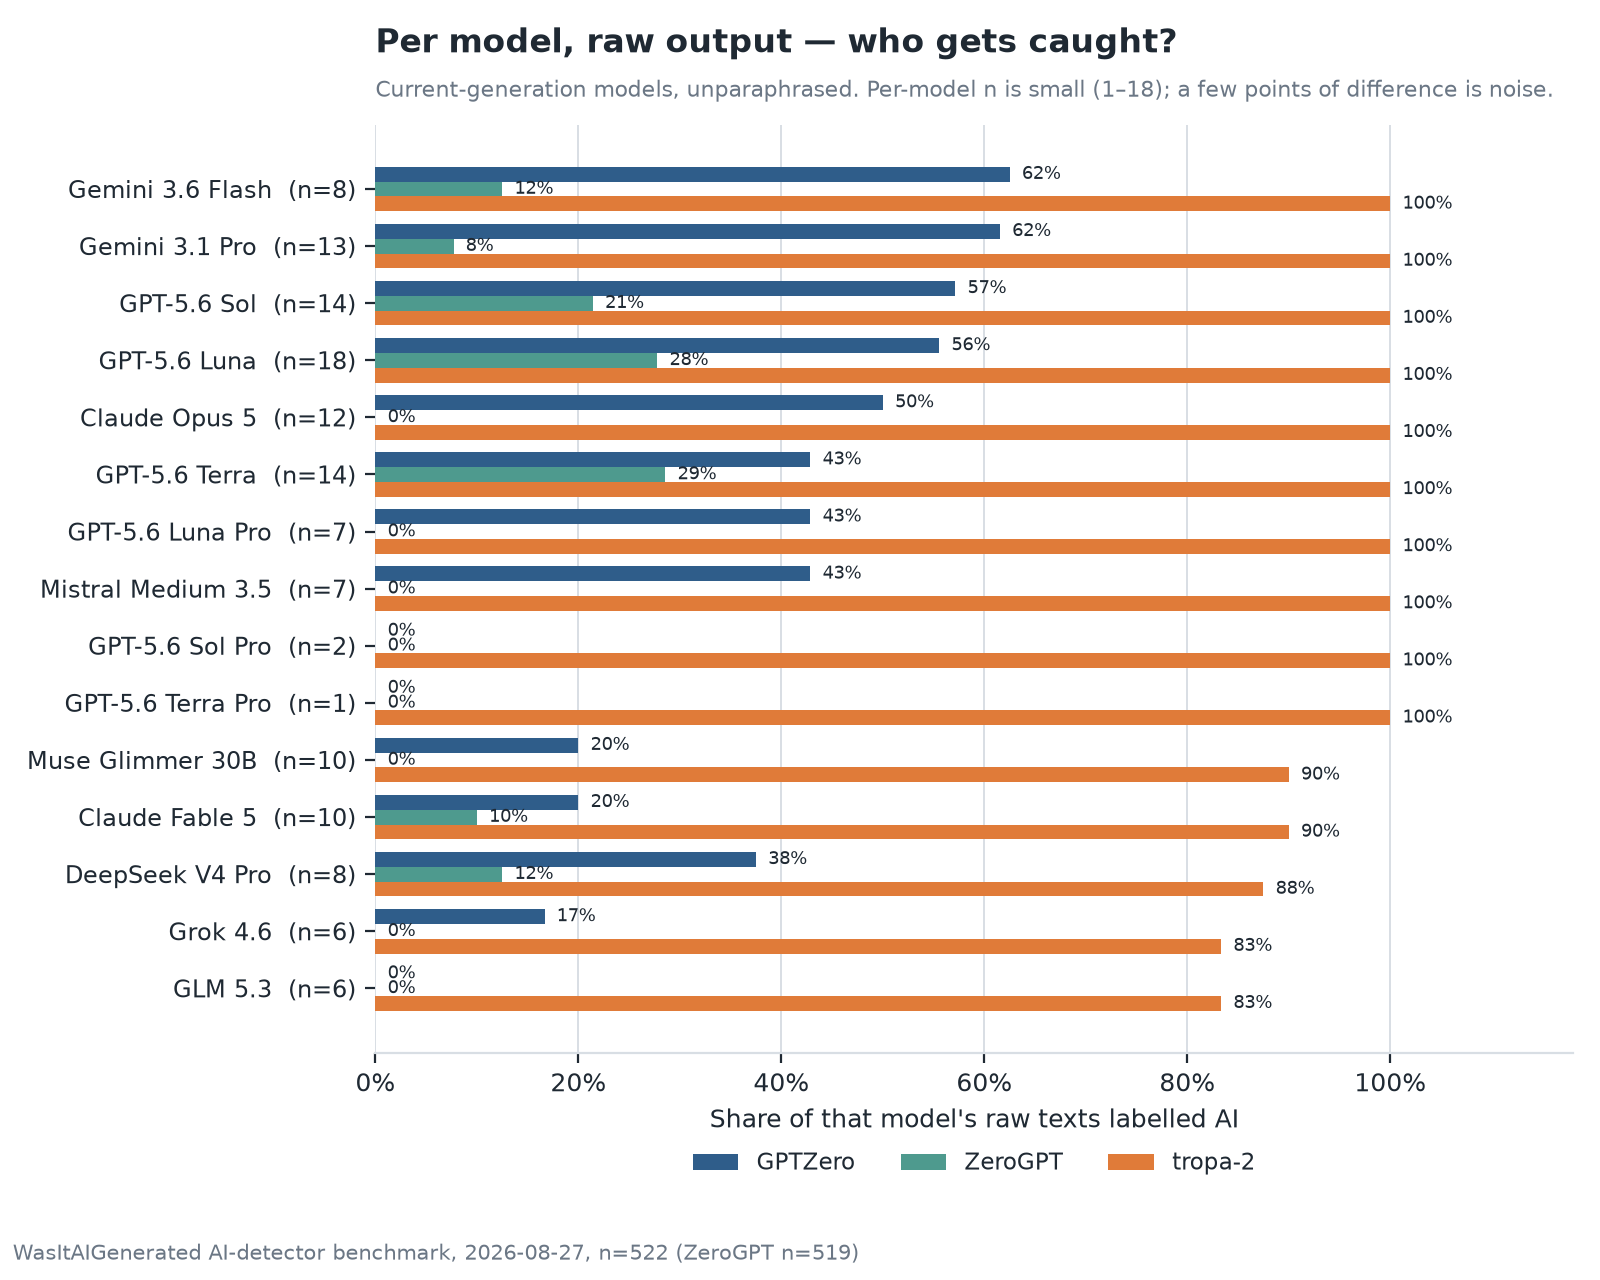
| Générateur (brut, actuel) | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| GPT-5.6 Sol | 14 | 57 % | 21 % | 100 % |
| GPT-5.6 Luna | 18 | 56 % | 28 % | 100 % |
| GPT-5.6 Terra | 14 | 43 % | 29 % | 100 % |
| GPT-5.6 Luna Pro | 7 | 43 % | 0 % | 100 % |
| Claude Opus 5 | 12 | 50 % | 0 % | 100 % |
| Claude Fable 5 | 10 | 20 % | 10 % | 90 % |
| Gemini 3.1 Pro | 13 | 62 % | 8 % | 100 % |
| Gemini 3.6 Flash | 8 | 62 % | 12 % | 100 % |
| DeepSeek V4 Pro | 8 | 38 % | 12 % | 88 % |
| Mistral Medium 3.5 | 7 | 43 % | 0 % | 100 % |
| Grok 4.6 | 6 | 17 % | 0 % | 83 % |
| GLM 5.3 | 6 | 0 % | 0 % | 83 % |
| Muse Glimmer 30B | 10 | 20 % | 0 % | 90 % |
(GPT-5.6 Sol Pro et Terra Pro, avec n = 2 et 1, figurent dans le graphique mais sont trop peu nombreux pour le tableau.)
Les modèles optimisés pour la qualité rédactionnelle sont les plus difficiles pour tous les outils : Claude Fable 5, Grok 4.6 et GLM 5.3 ferment la marche partout. Pour GPTZero, détecter un texte de GPT-5.6 n’est pas sensiblement plus difficile que détecter une sortie de Gemini (43–57 % contre 62 %). Claude Opus 5 obtient 50 % chez GPTZero, 0 % chez ZeroGPT et 100 % chez tropa-2, sur 12 textes.
Faux positifs : le chiffre qui compte vraiment
Un détecteur qui accuse de vrais étudiants est pire qu’inutile : cette section compte donc davantage que la précédente.
Les 251 textes humains couvrent 12 domaines : résumés arXiv antérieurs à 2017, CC-News, wikiHow, documentation technique, e-mails Enron, Reddit ELI5, recettes, fiction Gutenberg, Poetry Foundation, avis Yelp, pages web et 59 dissertations d’élèves issues de PERSUADE 2.0. GPTZero n’en a accusé aucun. tropa-2 en a accusé un : un court e-mail Enron. ZeroGPT en a accusé sept (3 recettes, puis un texte de chaque catégorie suivante : poésie, documentation technique, wikiHow et actualités).
251 textes, c’est un petit échantillon pour un taux que l’on veut citer au dixième près. Nous avons donc aussi soumis à tropa-2 3 000 dissertations d’élèves issues de PERSUADE 2.0 (de la 6e à la 12e année du système américain, toutes humaines, aucune utilisée pour l’entraînement). Il en a classé 2,6 % comme IA ; la dissertation médiane a obtenu 13,7 sur 100.
Nous n’allons pas enjoliver les choses. Sur les 59 dissertations de ce comparatif, nous avons observé 0 %, mais le passage sur 3 000 dissertations place le chiffre honnête pour les écrits d’élèves à environ 1 sur 40. Les faux positifs des détecteurs IA sur les copies d’étudiants sont un risque réel avec tous les outils du marché, le nôtre compris. Le verdict d’un détecteur ne devrait jamais être le seul fondement d’une accusation académique.
Notre méthode
Mêmes textes, même jour, réglages par défaut pour chaque détecteur. C’est le verdict propre à chaque outil qui compte : GPTZero — son étiquette ai (sa troisième classe, mixed, est une réponse légitime « en partie IA » ; nous la comptons ici comme non IA et la détaillons dans la FAQ). ZeroGPT — « AI/GPT generated » ou « most of your text is AI/GPT generated » comptent comme IA ; tout le reste, y compris « may include parts generated by AI », non. tropa-2 — l’étiquette « généré par IA » affichée sur le site, soit un score de 90 ou plus sur son échelle de 0 à 100.
La comparaison des étiquettes masque un compromis : un détecteur peut acheter de la détection en tolérant davantage de faux positifs. Pour les outils qui renvoient un score continu, nous avons donc aussi fixé le seuil sur les 251 textes humains de sorte qu’au plus un d’entre eux (0,4 %) soit classé IA, puis relu la détection à ce seuil. tropa-2 : 96,3 % sur le texte brut actuel, 74,0 % sur la paraphrase. Le pourcentage de ZeroGPT : 5,1 % / 2,1 %. GPTZero ne fournit pas de score par document sur lequel fixer un seuil. Le classement ne change pas.
Répartition par longueur : 379 textes courts (< 400 mots), 110 moyens (400–750), 33 longs (750–1 000+). Les textes humains sont antérieurs à 2022 chaque fois que la source permet de les dater, et aucun n’a servi à entraîner tropa-2.
Limites
- Les textes IA proviennent de notre propre chaîne de génération : des prompts miroirs construits sur des documents humains sources, plus une série de prompts pour des textes longs. Des textes du même style ont servi à entraîner tropa-2. Les 136 textes bruts de modèles actuels ont été tenus à l’écart, mais la distribution des prompts n’est pas fondamentalement différente. Considérez les chiffres de tropa-2 comme une borne haute, et ceux de GPTZero et de ZeroGPT comme des résultats à froid sur une distribution qu’ils ne connaissent pas.
- « En partie IA » est une réponse légitime. Pour un texte paraphrasé, le mixed de GPTZero ou le « may include parts generated by AI » de ZeroGPT peuvent être la bonne réponse. Les compter comme IA porterait GPTZero à 75,7 % et ZeroGPT à 23,5 % sur le texte brut actuel, et les faux positifs humains de ZeroGPT à 30,8 %. Nous avons retenu le verdict assuré de chaque outil et l’avons appliqué partout.
- Le n par générateur est faible : de 1 à 18 textes. Un écart de cinq points entre deux modèles sur ce graphique relève du bruit.
- Anglais uniquement, 522 textes. Ce n’est pas un grand benchmark.
- ZeroGPT n’a renvoyé aucun résultat pour trois textes ; ils sont exclus de sa colonne.
- Le texte humanisé est exclu. Une sortie IA passée dans des outils d’humanisation pose un problème différent et bien plus difficile ; tous les détecteurs testés ici s’en sortent nettement moins bien. Nous publierons ces résultats séparément.
- Un seul éditeur a mené l’évaluation, et cet éditeur, c’est nous. C’est précisément pour cela que chaque texte et chaque score sont publics : chacun peut la refaire ou la contredire.
Télécharger le jeu de données et reproduire les résultats
Tout se trouve dans le dépôt GitHub (wasitaigenerated/ai-detector-benchmark). Les textes IA et tous les scores sont sous licence CC BY 4.0 ; les textes humains conservent la licence de leur source, et les 32 lignes dont la redistribution n’est pas autorisée portent text: null ainsi qu’un text_sha256 pour que vous puissiez quand même les faire correspondre.
Le tableau principal en dix lignes :
import json, urllib.request

URL = "https://raw.githubusercontent.com/wasitaigenerated/ai-detector-benchmark/main/2026-08/benchmark_2026-08.jsonl"
rows = [json.loads(l) for l in urllib.request.urlopen(URL) if l.strip()]

for cat in ["human", "new_raw", "new_para", "old_raw", "old_para"]:
    sub = [r for r in rows if r["category"] == cat]
    zg  = [r for r in sub if r["zerogpt_class"]]
    gz  = sum(r["gptzero_predicted_class"] == "ai" for r in sub) / len(sub)
    z   = sum(r["zerogpt_class"] == "ai" for r in zg) / len(zg)
    t2  = sum(r["tropa2_score"] >= 90 for r in sub) / len(sub)
    print(f"{cat:9} n={len(sub):3}  gptzero={gz:5.1%}  zerogpt={z:5.1%}  tropa-2={t2:5.1%}")
Remplacez les scores par ceux de votre propre détecteur et vous obtenez une comparaison à armes égales. Envoyez-nous vos chiffres et nous les mettrons en lien ici, y compris ceux qui ne nous sont pas favorables.
FAQ
GPTZero vs ZeroGPT vs tropa-2 : quel détecteur IA est le plus fiable en 2026 ?
Sur ce corpus, tropa-2 a classé le plus de texte IA comme IA (93,4 %, contre 47,2 % pour GPTZero et 23,4 % pour ZeroGPT) avec un faible taux de faux positifs (0,4 %). GPTZero affiche le bilan le plus propre en matière de faux positifs : 0 sur 251 textes humains. ZeroGPT cumule le taux de détection le plus bas et le plus de faux positifs (2,8 %). Les textes IA proviennent de notre propre chaîne de génération : les chiffres de tropa-2 sont donc obtenus à domicile.
ZeroGPT est-il fiable ?
Pas sur les modèles actuels. Il a classé comme IA 11,8 % du texte brut des modèles de 2026, avec 0 % sur Claude Opus 5, Grok 4.6, GLM 5.3 et Mistral. Sur les modèles de la génération précédente, il atteignait 90 %. Il a en outre apposé son avertissement plus nuancé, « may include parts generated by AI » (peut contenir des passages générés par IA), à 30,8 % des textes humains, dont 85 % des articles wikiHow et 88 % des recettes.
La classe « mixed » de GPTZero compte-t-elle ?
C’est une troisième réponse légitime, pas un échec. Si on la compte comme IA, GPTZero passe de 41,9 % à 75,7 % sur le texte brut actuel et de 2,0 % à 62,0 % sur la paraphrase actuelle, sans changement pour ses zéro faux positifs. Les tableaux ci-dessus n’utilisent que son étiquette assurée « ai ».
Les détecteurs IA savent-ils repérer un texte de GPT-5.6 ?
En partie. Sur la sortie brute de GPT-5.6, GPTZero obtient entre 43 et 57 % selon la variante (Sol 57 %, Luna 56 %, Terra 43 %), ZeroGPT entre 21 et 29 %, tropa-2 100 %. La sortie paraphrasée de GPT-5.6 est bien plus difficile pour tous les outils.
Les détecteurs IA produisent-ils des faux positifs sur les copies d’étudiants ?
Oui, et c’est le chiffre à surveiller. Sur les 59 dissertations PERSUADE de ce test, GPTZero, ZeroGPT et tropa-2 n’en ont accusé aucune. Sur un passage plus large de 3 000 dissertations PERSUADE, tropa-2 en a accusé 2,6 %. Le verdict d’un détecteur ne devrait jamais être la seule preuve dans une affaire d’intégrité académique.
Pourquoi un texte IA paraphrasé obtient-il un score plus bas qu’un texte IA brut ?
La paraphrase ancre la sortie dans la structure, le vocabulaire et l’ordre des arguments d’un document humain : une grande partie du signal sur lequel s’appuie un détecteur est donc héritée d’une personne. C’est la principale faiblesse mise en évidence par ce comparatif : GPTZero 2,0 %, ZeroGPT 2,1 %, tropa-2 74,0 % sur la paraphrase de modèles actuels, contre 96,3 % sur le texte brut.
Analysez un document vous-même
Collez-le dans WasItAIGenerated. Les analyses tournent désormais sur tropa-3, notre modèle actuel.
Tester tropa-3 gratuitement