Die meisten Vergleiche von KI-Detektoren hinken den Modellen, die sie erkennen sollen, um ein Jahr hinterher. Deshalb haben wir einen neuen Datensatz gebaut: 522 englische Texte mit 177.512 Wörtern, davon 251 von Menschen geschrieben und 271 von aktuellen LLMs sowie Modellen der Vorgängergeneration erzeugt. Am 27. August 2026 haben wir alles durch GPTZero, ZeroGPT und unseren eigenen Detektor tropa-2 laufen lassen.
Ein Urteil pro Detektor und Text. Jeder Text und jeder Score ist öffentlich, Sie können also jede Zahl unten selbst nachprüfen.
Das Wichtigste in Kürze
- Aktuelle Modelle schlüpfen an den meisten Detektoren vorbei. Bei unbearbeitetem Text von GPT-5.6, Claude Opus 5 / Fable 5, Gemini 3.6, Grok 4.6 und Co. (n = 136) stufte GPTZero 41,9 % als KI ein, ZeroGPT 11,8 %, tropa-2 96,3 %.
- Die Modelle des Vorjahrs sind ein gelöstes Problem: GPTZero 100 %, ZeroGPT 90 %, tropa-2 100 %. Wie schwer die Erkennung ist, hängt fast ausschließlich davon ab, wie neu das Modell ist.
- Fehlalarme: Bei 251 menschlichen Texten beschuldigte GPTZero keinen, tropa-2 einen (0,4 %), ZeroGPT sieben (2,8 %).
- Paraphrasen sind für alle der schwierige Fall: Wenn ein aktuelles Modell einen menschlichen Text umschreibt, erkennt GPTZero 2,0 %, ZeroGPT 2,1 %, tropa-2 74,0 %.
- Ein Vorbehalt, bevor Sie etwas zitieren: Die KI-Texte stammen aus unserer eigenen Generierungs-Pipeline. Der Datensatz liegt damit näher an der Trainingsverteilung von tropa-2 als an der von GPTZero oder ZeroGPT.
Die Ergebnisse
Anteil der Texte, die der jeweilige Detektor als KI eingestuft hat. In der Zeile für menschliche Texte ist das die Falsch-Positiv-Rate (niedriger ist besser), in allen anderen die Erkennungsrate (höher ist besser). ZeroGPT lieferte für 3 Texte kein Ergebnis, seine Spalte bezieht sich daher auf 519.
| Kategorie | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| Mensch (Fehlalarme) | 251 | 0,0 % | 2,8 % | 0,4 % |
| KI, gesamt | 271 | 47,2 % | 23,4 % | 93,4 % |
| Aktuelle Modelle, roh | 136 | 41,9 % | 11,8 % | 96,3 % |
| Aktuelle Modelle, Paraphrase | 50 | 2,0 % | 2,1 % | 74,0 % |
| Vorgängermodelle, roh | 50 | 100 % | 90,0 % | 100 % |
| Vorgängermodelle, Paraphrase | 35 | 57,1 % | 2,9 % | 100 % |
Die beiden unteren Zeilen im Vergleich zu den beiden mittleren erzählen die ganze Geschichte. Eine Modellgeneration weiter, und GPTZero fällt von 100 % auf 41,9 %, ZeroGPT von 90 % auf 11,8 %.
Nach Modell: Wer wird erkannt?
Unbearbeitete, nicht paraphrasierte Ausgabe aktueller Modelle. Das n pro Modell ist klein (1–18 Texte), einzelne Zeilen zeigen also nur eine Tendenz.
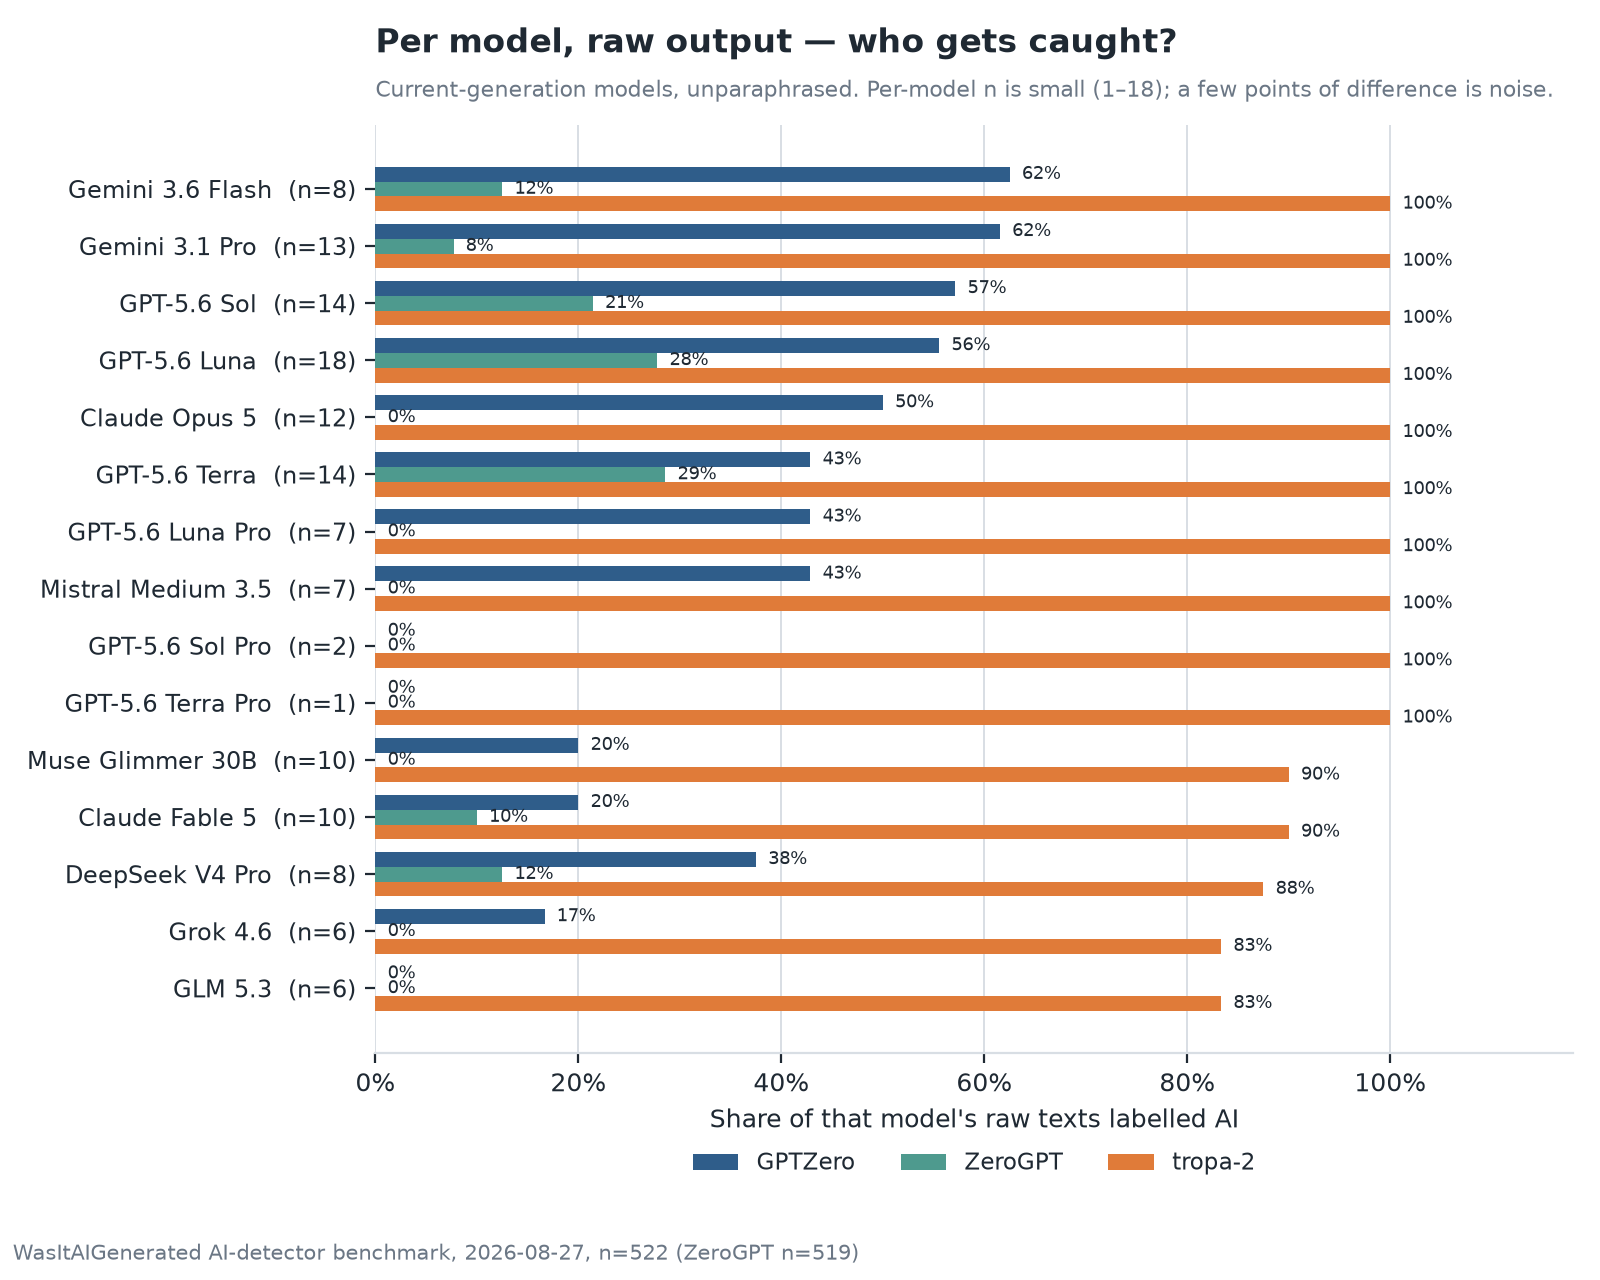
| Generator (roh, aktuell) | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| GPT-5.6 Sol | 14 | 57 % | 21 % | 100 % |
| GPT-5.6 Luna | 18 | 56 % | 28 % | 100 % |
| GPT-5.6 Terra | 14 | 43 % | 29 % | 100 % |
| GPT-5.6 Luna Pro | 7 | 43 % | 0 % | 100 % |
| Claude Opus 5 | 12 | 50 % | 0 % | 100 % |
| Claude Fable 5 | 10 | 20 % | 10 % | 90 % |
| Gemini 3.1 Pro | 13 | 62 % | 8 % | 100 % |
| Gemini 3.6 Flash | 8 | 62 % | 12 % | 100 % |
| DeepSeek V4 Pro | 8 | 38 % | 12 % | 88 % |
| Mistral Medium 3.5 | 7 | 43 % | 0 % | 100 % |
| Grok 4.6 | 6 | 17 % | 0 % | 83 % |
| GLM 5.3 | 6 | 0 % | 0 % | 83 % |
| Muse Glimmer 30B | 10 | 20 % | 0 % | 90 % |
(GPT-5.6 Sol Pro und Terra Pro mit n = 2 bzw. 1 sind im Diagramm enthalten, aber für die Tabelle zu klein.)
Auf Prosaqualität getrimmte Modelle sind für jedes Tool am schwierigsten: Claude Fable 5, Grok 4.6 und GLM 5.3 landen durchweg am unteren Ende. Für GPTZero ist GPT-5.6-Text nicht nennenswert schwerer zu erkennen als Gemini-Ausgabe (43–57 % gegenüber 62 %). Claude Opus 5 kam bei 12 Texten auf 50 % bei GPTZero, 0 % bei ZeroGPT und 100 % bei tropa-2.
Fehlalarme: die Zahl, auf die es wirklich ankommt
Ein Detektor, der echte Studierende beschuldigt, ist schlimmer als nutzlos. Dieser Abschnitt zählt deshalb mehr als der vorige.
Die 251 menschlichen Texte decken 12 Bereiche ab: arXiv-Abstracts von vor 2017, CC-News, wikiHow, technische Dokumentation, Enron-E-Mails, Reddit ELI5, Rezepte, Gutenberg-Belletristik, Poetry Foundation, Yelp-Bewertungen, Webseiten und 59 Schüleraufsätze aus PERSUADE 2.0. GPTZero beschuldigte keinen davon. tropa-2 beschuldigte einen: eine kurze Enron-E-Mail. ZeroGPT beschuldigte sieben (3 Rezepte sowie je einen Text aus Lyrik, technischer Dokumentation, wikiHow und Nachrichten).
251 Texte sind eine kleine Stichprobe für eine Rate, die man auf Zehntelprozent genau angeben möchte. Deshalb haben wir tropa-2 zusätzlich auf 3.000 Schüleraufsätze aus PERSUADE 2.0 angewendet (Klassenstufen 6–12, alle von Menschen verfasst, keiner im Training verwendet). Dort stufte es 2,6 % als KI ein; der Median-Aufsatz erzielte 13,7 von 100.
Wir werden das nicht schönreden. Bei den 59 Aufsätzen dieses Vergleichs sahen wir 0 %, doch der Durchlauf mit 3.000 Aufsätzen beziffert den ehrlichen Wert für Schülertexte auf etwa 1 von 40. Fehlalarme von KI-Detektoren bei Schüler- und Studierendenaufsätzen sind bei jedem Tool auf dem Markt ein reales Risiko, unseres eingeschlossen. Das Urteil eines Detektors sollte nie die alleinige Grundlage für einen Täuschungsvorwurf sein.
So sind wir vorgegangen
Dieselben Texte, derselbe Tag, Standardeinstellungen bei jedem Detektor. Es zählt jeweils das eigene Urteil des Tools: GPTZero – sein Label ai (die dritte Klasse, mixed, ist eine legitime Ausgabe für „teilweise KI“; wir werten sie hier als nicht KI und gehen in den FAQ darauf ein). ZeroGPT – „AI/GPT generated“ oder „most of your text is AI/GPT generated“ zählen als KI; alles andere, einschließlich „may include parts generated by AI“, nicht. tropa-2 – das auf der Website angezeigte Label „KI-generiert“, also ein Score von 90 oder mehr auf der Skala von 0 bis 100.
Der Label-Vergleich verdeckt einen Zielkonflikt: Ein Detektor kann sich höhere Erkennung durch mehr Fehlalarme erkaufen. Für die Tools mit kontinuierlichem Score haben wir die Schwelle daher zusätzlich an den 251 menschlichen Texten so festgelegt, dass höchstens einer davon (0,4 %) als KI eingestuft wird, und die Erkennung bei dieser Schwelle erneut gemessen. tropa-2: 96,3 % bei aktuellem unbearbeitetem Text, 74,0 % bei Paraphrasen. Der Prozentwert von ZeroGPT: 5,1 % / 2,1 %. GPTZero liefert keinen Dokument-Score, auf den sich eine Schwelle setzen ließe. An der Rangfolge ändert sich nichts.
Verteilung nach Länge: 379 kurze Texte (< 400 Wörter), 110 mittlere (400–750), 33 lange (750–1.000+). Die menschlichen Texte stammen aus der Zeit vor 2022, soweit die Quelle eine Datierung zulässt, und keiner davon wurde zum Training von tropa-2 verwendet.
Einschränkungen
- Die KI-Texte stammen aus unserer eigenen Generierungs-Pipeline – Spiegel-Prompts auf Basis menschlicher Quelldokumente sowie eine Reihe von Prompts für Langtexte. Texte im gleichen Stil wurden zum Training von tropa-2 verwendet. Die 136 unbearbeiteten Texte aktueller Modelle wurden zurückgehalten, doch die Prompt-Verteilung unterscheidet sich nicht grundsätzlich. Betrachten Sie die Zahlen von tropa-2 als Obergrenze und die von GPTZero und ZeroGPT als Kaltstart-Ergebnisse auf einer ihnen unbekannten Verteilung.
- „Teilweise KI“ ist eine legitime Ausgabe. Bei einem paraphrasierten Text können GPTZeros mixed oder ZeroGPTs „may include parts generated by AI“ die richtige Antwort sein. Würde man sie als KI werten, käme GPTZero bei aktuellem unbearbeitetem Text auf 75,7 % und ZeroGPT auf 23,5 % – und ZeroGPTs Fehlalarme bei menschlichen Texten auf 30,8 %. Wir haben für jedes Tool das eindeutige eigene Urteil gewählt und durchgängig angewendet.
- Das n pro Generator ist klein – 1 bis 18 Texte. Ein Unterschied von fünf Punkten zwischen zwei Modellen in diesem Diagramm ist Rauschen.
- Nur Englisch, 522 Texte. Kein großer Benchmark.
- ZeroGPT lieferte für drei Texte kein Ergebnis; sie sind aus seiner Spalte ausgeschlossen.
- Humanisierter Text ist nicht enthalten. KI-Ausgabe, die durch Humanizer-Tools gelaufen ist, ist ein anderes und deutlich schwierigeres Problem; jeder Detektor hier schneidet damit spürbar schlechter ab. Dazu veröffentlichen wir separat.
- Die Auswertung stammt von einem einzigen Anbieter, und dieser Anbieter sind wir – genau deshalb ist jeder Text und jeder Score öffentlich, damit jeder sie wiederholen oder widerlegen kann.
Datensatz herunterladen und selbst nachrechnen
Alles liegt im GitHub-Repository (wasitaigenerated/ai-detector-benchmark). KI-Texte und alle Scores stehen unter CC BY 4.0; menschliche Texte behalten die Lizenz ihrer Quelle, und 32 Zeilen, deren Weitergabe nicht erlaubt ist, enthalten text: null sowie einen text_sha256, damit Sie sie trotzdem zuordnen können.
Die Haupttabelle in zehn Zeilen:
import json, urllib.request

URL = "https://raw.githubusercontent.com/wasitaigenerated/ai-detector-benchmark/main/2026-08/benchmark_2026-08.jsonl"
rows = [json.loads(l) for l in urllib.request.urlopen(URL) if l.strip()]

for cat in ["human", "new_raw", "new_para", "old_raw", "old_para"]:
    sub = [r for r in rows if r["category"] == cat]
    zg  = [r for r in sub if r["zerogpt_class"]]
    gz  = sum(r["gptzero_predicted_class"] == "ai" for r in sub) / len(sub)
    z   = sum(r["zerogpt_class"] == "ai" for r in zg) / len(zg)
    t2  = sum(r["tropa2_score"] >= 90 for r in sub) / len(sub)
    print(f"{cat:9} n={len(sub):3}  gptzero={gz:5.1%}  zerogpt={z:5.1%}  tropa-2={t2:5.1%}")
Setzen Sie die Scores Ihres eigenen Detektors ein, und Sie haben einen direkten Vergleich unter gleichen Bedingungen. Schicken Sie uns die Zahlen, und wir verlinken sie hier – auch die, bei denen wir schlecht aussehen.
FAQ
GPTZero vs. ZeroGPT vs. tropa-2: Welcher KI-Detektor ist 2026 am genauesten?
In diesem Datensatz erkannte tropa-2 den größten Anteil an KI-Text als KI (93,4 %, gegenüber 47,2 % bei GPTZero und 23,4 % bei ZeroGPT) – bei einer niedrigen Falsch-Positiv-Rate (0,4 %). GPTZero hatte die sauberste Bilanz bei Fehlalarmen: 0 von 251 menschlichen Texten. ZeroGPT kam sowohl auf die niedrigste Erkennungsrate als auch auf die meisten Fehlalarme (2,8 %). Die KI-Texte stammen aus unserer eigenen Generierungs-Pipeline; die Zahlen von tropa-2 sind also ein Heimspiel-Ergebnis.
Ist ZeroGPT zuverlässig?
Nicht bei aktuellen Modellen. ZeroGPT stufte 11,8 % des unbearbeiteten Texts von Modellen aus 2026 als KI ein – bei Claude Opus 5, Grok 4.6, GLM 5.3 und Mistral 0 %. Bei Modellen der Vorgängergeneration erreichte es 90 %. Außerdem versah es 30,8 % der menschlichen Texte mit seinem schwächeren Hinweis „may include parts generated by AI“ (kann KI-generierte Teile enthalten), darunter 85 % der wikiHow-Artikel und 88 % der Rezepte.
Zählt die Klasse „mixed“ von GPTZero?
Sie ist eine legitime dritte Ausgabe, kein Fehlschlag. Wertet man sie als KI, steigt GPTZero bei aktuellem unbearbeitetem Text von 41,9 % auf 75,7 % und bei aktuellen Paraphrasen von 2,0 % auf 62,0 % – ohne Änderung an seinen null Fehlalarmen. Die Tabellen oben verwenden nur das eindeutige Label „ai“.
Können KI-Detektoren Text von GPT-5.6 erkennen?
Teilweise. Bei unbearbeiteter GPT-5.6-Ausgabe lag GPTZero je nach Variante bei 43–57 % (Sol 57 %, Luna 56 %, Terra 43 %), ZeroGPT bei 21–29 %, tropa-2 bei 100 %. Paraphrasierte GPT-5.6-Ausgabe ist für jedes Tool deutlich schwieriger.
Erzeugen KI-Detektoren Fehlalarme bei Schüler- und Studierendenaufsätzen?
Ja, und genau auf diese Zahl kommt es an. Bei den 59 PERSUADE-Aufsätzen in diesem Test beschuldigten GPTZero, ZeroGPT und tropa-2 keinen einzigen. In einem größeren Durchlauf mit 3.000 PERSUADE-Aufsätzen beschuldigte tropa-2 2,6 %. Das Urteil eines Detektors sollte in einem Verfahren zur akademischen Integrität nie der einzige Beleg sein.
Warum schneidet paraphrasierter KI-Text schlechter ab als unbearbeiteter KI-Text?
Beim Paraphrasieren bleibt die Ausgabe an Struktur, Wortschatz und Argumentationsreihenfolge eines menschlichen Dokuments gebunden – ein großer Teil des Signals, auf das ein Detektor achtet, stammt also von einem Menschen. Das ist die größte Schwachstelle in diesem Vergleich: GPTZero 2,0 %, ZeroGPT 2,1 %, tropa-2 74,0 % bei Paraphrasen aktueller Modelle, gegenüber 96,3 % bei unbearbeitetem Text.
Prüfen Sie selbst ein Dokument
Fügen Sie es in WasItAIGenerated ein. Prüfungen laufen inzwischen auf tropa-3, unserem aktuellen Modell.
tropa-3 kostenlos testen