La mayoría de las comparativas de detectores de IA van un año por detrás de los modelos que se supone que deben pillar. Por eso montamos un conjunto nuevo: 522 textos en inglés, 177.512 palabras; 251 escritos por personas y 271 generados por LLM actuales y de la generación anterior. El 27 de agosto de 2026 lo pasamos entero por GPTZero, ZeroGPT y nuestro propio detector, tropa-2.
Un veredicto por detector y por texto. Todos los textos y todas las puntuaciones son públicos, así que puedes comprobar cualquier cifra de las que siguen.
En resumen
- Los modelos actuales se cuelan en la mayoría de los detectores. Con texto sin editar de GPT-5.6, Claude Opus 5 / Fable 5, Gemini 3.6, Grok 4.6 y compañía (n = 136), GPTZero marcó como IA el 41,9 %, ZeroGPT el 11,8 % y tropa-2 el 96,3 %.
- Los modelos del año pasado son un problema resuelto: GPTZero 100 %, ZeroGPT 90 %, tropa-2 100 %. La dificultad de detección depende casi por completo de lo reciente que sea el modelo.
- Falsos positivos: sobre 251 textos humanos, GPTZero no acusó a ninguno, tropa-2 a uno (0,4 %) y ZeroGPT a siete (2,8 %).
- La paráfrasis es el caso difícil para todos: cuando un modelo actual reescribe un texto humano, GPTZero detecta el 2,0 %, ZeroGPT el 2,1 % y tropa-2 el 74,0 %.
- Una advertencia antes de citar nada: los textos de IA salen de nuestra propia cadena de generación, así que este conjunto se parece más a la distribución de entrenamiento de tropa-2 que a la de GPTZero o ZeroGPT.
Los resultados
Porcentaje de textos que cada detector etiquetó como IA. En la fila de textos humanos es la tasa de falsos positivos (cuanto más baja, mejor); en las demás, la tasa de detección (cuanto más alta, mejor). ZeroGPT no devolvió resultado para 3 textos, así que su columna se calcula sobre 519.
| Categoría | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| Humano (falsos positivos) | 251 | 0,0 % | 2,8 % | 0,4 % |
| IA, total | 271 | 47,2 % | 23,4 % | 93,4 % |
| Modelos actuales, sin editar | 136 | 41,9 % | 11,8 % | 96,3 % |
| Modelos actuales, paráfrasis | 50 | 2,0 % | 2,1 % | 74,0 % |
| Modelos anteriores, sin editar | 50 | 100 % | 90,0 % | 100 % |
| Modelos anteriores, paráfrasis | 35 | 57,1 % | 2,9 % | 100 % |
Las dos últimas filas frente a las dos centrales lo resumen todo. Basta con subir una generación de modelos para que GPTZero caiga del 100 % al 41,9 % y ZeroGPT del 90 % al 11,8 %.
Por modelo: a quién se pilla
Salida sin editar ni parafrasear de los modelos actuales. El n por modelo es pequeño (de 1 a 18 textos), así que cada fila debe leerse como una tendencia orientativa.
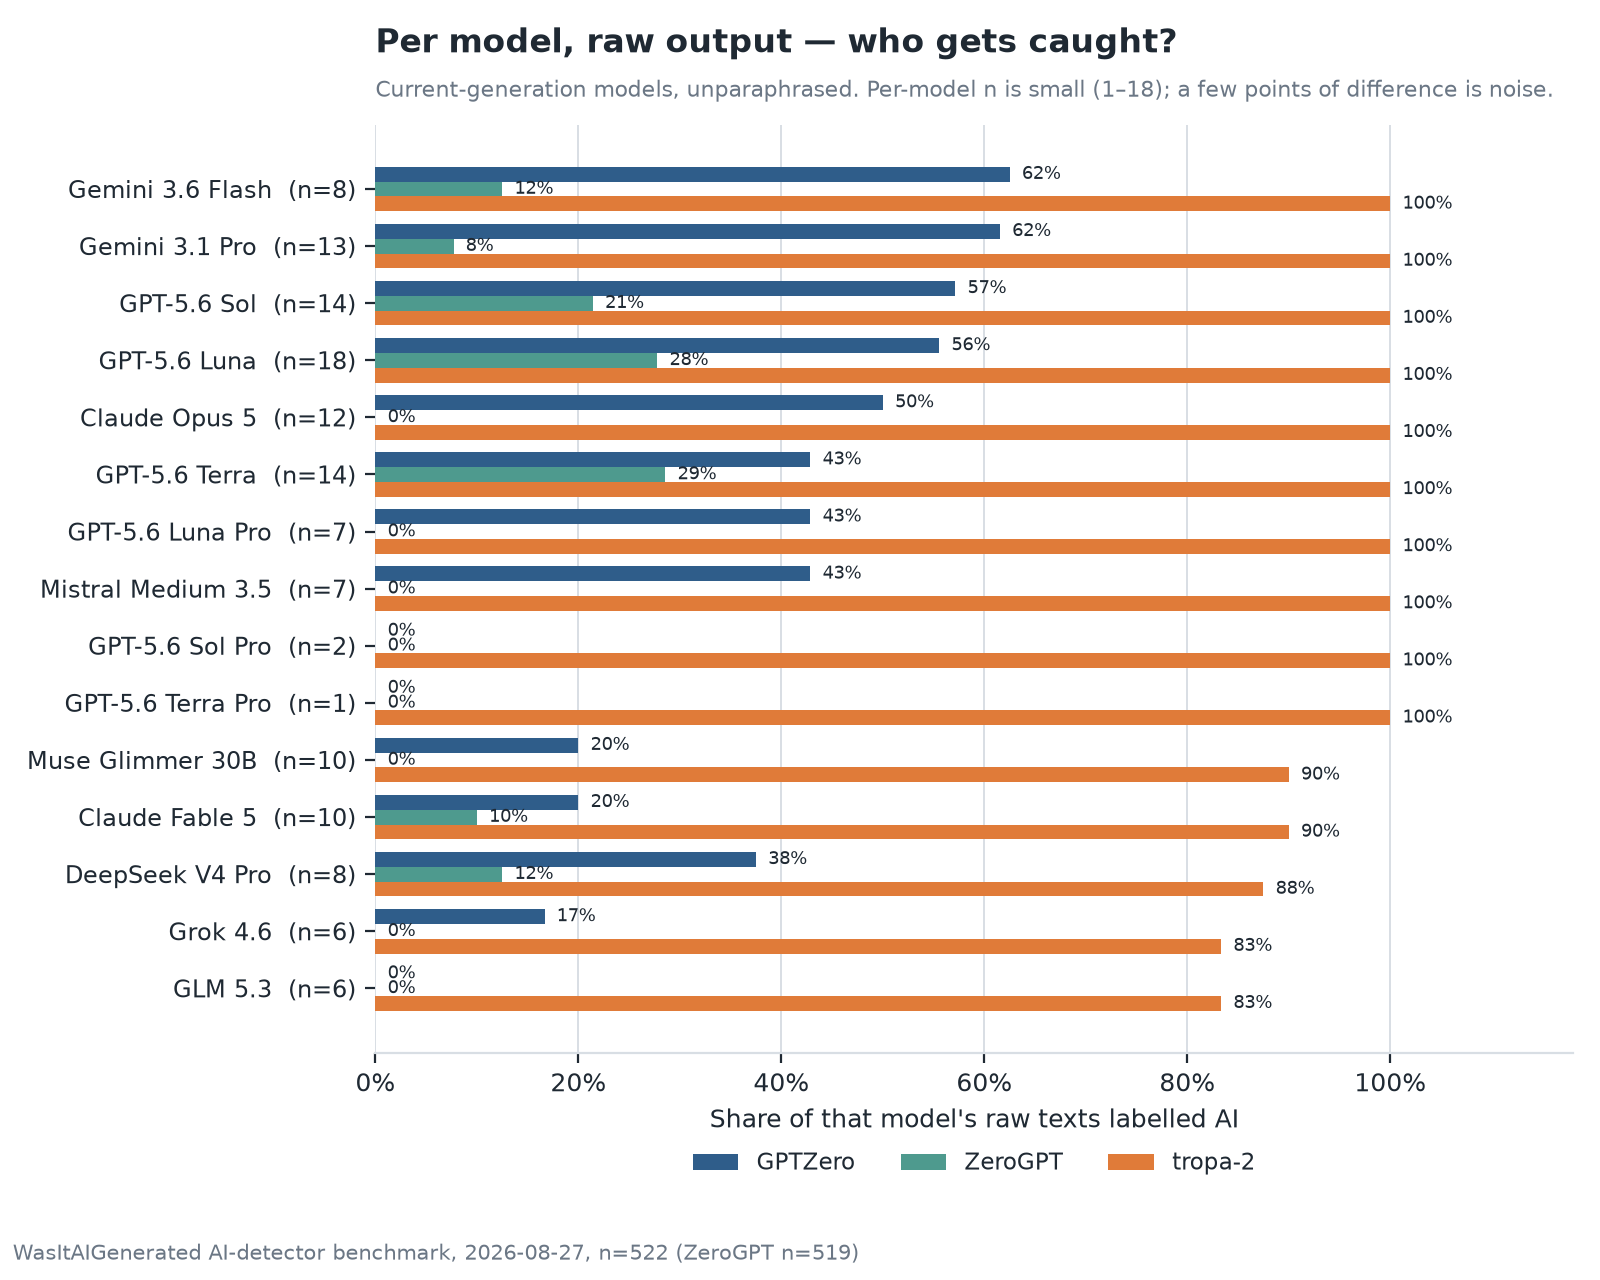
| Generador (sin editar, actual) | n | GPTZero | ZeroGPT | tropa-2 |
|---|---|---|---|---|
| GPT-5.6 Sol | 14 | 57 % | 21 % | 100 % |
| GPT-5.6 Luna | 18 | 56 % | 28 % | 100 % |
| GPT-5.6 Terra | 14 | 43 % | 29 % | 100 % |
| GPT-5.6 Luna Pro | 7 | 43 % | 0 % | 100 % |
| Claude Opus 5 | 12 | 50 % | 0 % | 100 % |
| Claude Fable 5 | 10 | 20 % | 10 % | 90 % |
| Gemini 3.1 Pro | 13 | 62 % | 8 % | 100 % |
| Gemini 3.6 Flash | 8 | 62 % | 12 % | 100 % |
| DeepSeek V4 Pro | 8 | 38 % | 12 % | 88 % |
| Mistral Medium 3.5 | 7 | 43 % | 0 % | 100 % |
| Grok 4.6 | 6 | 17 % | 0 % | 83 % |
| GLM 5.3 | 6 | 0 % | 0 % | 83 % |
| Muse Glimmer 30B | 10 | 20 % | 0 % | 90 % |
(GPT-5.6 Sol Pro y Terra Pro, con n = 2 y 1, aparecen en el gráfico, pero son demasiado pocos para tabularlos).
Los modelos afinados para la calidad de la prosa son los más difíciles para todas las herramientas: Claude Fable 5, Grok 4.6 y GLM 5.3 quedan a la cola en todos los casos. Para GPTZero, detectar texto de GPT-5.6 no es mucho más difícil que detectar la salida de Gemini (43–57 % frente a 62 %). Claude Opus 5 se quedó en el 50 % con GPTZero, el 0 % con ZeroGPT y el 100 % con tropa-2, sobre 12 textos.
Falsos positivos: la cifra que de verdad importa
Un detector que señala a estudiantes reales es peor que inútil, así que esta sección importa más que la anterior.
Los 251 textos humanos abarcan 12 ámbitos: resúmenes de arXiv anteriores a 2017, CC-News, wikiHow, documentación técnica, correos de Enron, Reddit ELI5, recetas, ficción de Gutenberg, Poetry Foundation, reseñas de Yelp, páginas web y 59 ensayos de estudiantes de PERSUADE 2.0. GPTZero no acusó a ninguno. tropa-2 acusó a uno: un correo breve de Enron. ZeroGPT acusó a siete (3 recetas y uno de cada uno de poesía, documentación técnica, wikiHow y noticias).
251 textos son una muestra pequeña para una tasa que quieres citar con décimas, así que también pasamos tropa-2 por 3.000 ensayos de estudiantes de PERSUADE 2.0 (de 6.º a 12.º curso, todos humanos, ninguno usado en el entrenamiento). Ahí etiquetó como IA el 2,6 %; la mediana de los ensayos puntuó 13,7 sobre 100.
No vamos a maquillarlo. Con los 59 ensayos de esta comparativa vimos un 0 %, pero la ejecución con 3.000 ensayos sitúa la cifra honesta para textos de estudiantes en aproximadamente 1 de cada 40. Los falsos positivos de los detectores de IA con redacciones de estudiantes son un riesgo real con todas las herramientas del mercado, la nuestra incluida. El veredicto de un detector nunca debería ser la única base de una acusación académica.
Cómo lo hicimos
Mismos textos, mismo día y la configuración por defecto de cada detector. Cuenta el veredicto propio de cada herramienta: GPTZero, su etiqueta ai (su tercera clase, mixed, es una respuesta legítima de "IA en parte"; aquí la contamos como no IA y la comentamos en las preguntas frecuentes). ZeroGPT: "AI/GPT generated" o "most of your text is AI/GPT generated" cuentan como IA; todo lo demás, incluido "may include parts generated by AI", no. tropa-2: la etiqueta "generado por IA" que muestra la web, es decir, una puntuación de 90 o más en su escala de 0 a 100.
La comparación de etiquetas esconde un compromiso: un detector puede comprar detección a cambio de tolerar más falsos positivos. Por eso, en las herramientas que devuelven una puntuación continua, fijamos también el umbral sobre los 251 textos humanos de modo que como mucho uno de ellos (0,4 %) se etiquete como IA, y volvimos a medir la detección con ese umbral. tropa-2: 96,3 % en texto actual sin editar y 74,0 % en paráfrasis. El porcentaje de ZeroGPT: 5,1 % / 2,1 %. GPTZero no ofrece una puntuación por documento sobre la que fijar un umbral. La clasificación no cambia.
Reparto por longitud: 379 textos cortos (< 400 palabras), 110 medianos (400–750) y 33 largos (750–1.000+). Los textos humanos son anteriores a 2022 siempre que la fuente permite fecharlos, y ninguno se usó para entrenar tropa-2.
Limitaciones
- Los textos de IA salen de nuestra propia cadena de generación: prompts espejo a partir de documentos humanos de origen, más un conjunto de prompts de formato largo. Para entrenar tropa-2 se usaron textos del mismo estilo. Los 136 textos sin editar de modelos actuales se reservaron, pero la distribución de prompts no es distinta en lo esencial. Toma las cifras de tropa-2 como un techo, y las de GPTZero y ZeroGPT como resultados en frío sobre una distribución que no conocen.
- "IA en parte" es una respuesta legítima. Ante un texto parafraseado, el mixed de GPTZero o el "may include parts generated by AI" de ZeroGPT pueden ser la respuesta correcta. Contarlos como IA subiría a GPTZero al 75,7 % y a ZeroGPT al 23,5 % en texto actual sin editar, y los falsos positivos humanos de ZeroGPT al 30,8 %. Elegimos el veredicto seguro de cada herramienta y lo aplicamos en todos los casos.
- El n por generador es pequeño: de 1 a 18 textos. Una diferencia de cinco puntos entre dos modelos en ese gráfico es ruido.
- Solo inglés, 522 textos. No es una comparativa grande.
- ZeroGPT no devolvió resultado para tres textos; se excluyen de su columna.
- El texto humanizado queda fuera. La salida de IA pasada por herramientas de humanización es un problema distinto y mucho más difícil; todos los detectores de esta prueba rinden claramente peor con ella. Lo publicaremos por separado.
- La evaluación la hizo un único proveedor, y ese proveedor somos nosotros. Precisamente por eso todos los textos y puntuaciones son públicos: cualquiera puede repetirla o contradecirla.
Descarga el conjunto de datos y reprodúcelo
Todo está en el repositorio de GitHub (wasitaigenerated/ai-detector-benchmark). Los textos de IA y todas las puntuaciones tienen licencia CC BY 4.0; los textos humanos conservan la licencia de su fuente, y las 32 filas cuya redistribución no está permitida llevan text: null y un text_sha256 para que puedas emparejarlas igualmente.
La tabla principal en diez líneas:
import json, urllib.request

URL = "https://raw.githubusercontent.com/wasitaigenerated/ai-detector-benchmark/main/2026-08/benchmark_2026-08.jsonl"
rows = [json.loads(l) for l in urllib.request.urlopen(URL) if l.strip()]

for cat in ["human", "new_raw", "new_para", "old_raw", "old_para"]:
    sub = [r for r in rows if r["category"] == cat]
    zg  = [r for r in sub if r["zerogpt_class"]]
    gz  = sum(r["gptzero_predicted_class"] == "ai" for r in sub) / len(sub)
    z   = sum(r["zerogpt_class"] == "ai" for r in zg) / len(zg)
    t2  = sum(r["tropa2_score"] >= 90 for r in sub) / len(sub)
    print(f"{cat:9} n={len(sub):3}  gptzero={gz:5.1%}  zerogpt={z:5.1%}  tropa-2={t2:5.1%}")
Sustituye las puntuaciones por las de tu propio detector y tendrás una comparación en igualdad de condiciones. Envíanos los resultados y los enlazaremos aquí, también los que nos dejen en mal lugar.
Preguntas frecuentes
GPTZero vs ZeroGPT vs tropa-2: ¿qué detector de IA es más preciso en 2026?
En este conjunto, tropa-2 fue el que más texto de IA identificó como IA (93,4 %, frente al 47,2 % de GPTZero y el 23,4 % de ZeroGPT), con una tasa de falsos positivos baja (0,4 %). GPTZero tuvo el historial de falsos positivos más limpio: 0 de 251 textos humanos. ZeroGPT obtuvo a la vez la tasa de detección más baja y la mayor cantidad de falsos positivos (2,8 %). Los textos de IA salen de nuestra propia cadena de generación, así que las cifras de tropa-2 son un resultado jugando en casa.
¿Es preciso ZeroGPT?
No con los modelos actuales. Marcó como IA el 11,8 % del texto sin editar de los modelos de 2026, con un 0 % en Claude Opus 5, Grok 4.6, GLM 5.3 y Mistral. Con modelos de la generación anterior llegó al 90 %. Además, colgó su aviso más suave, "may include parts generated by AI" (puede incluir partes generadas por IA), al 30,8 % de los textos humanos, entre ellos el 85 % de los artículos de wikiHow y el 88 % de las recetas.
¿Cuenta la clase "mixed" de GPTZero?
Es una tercera respuesta legítima, no un fallo. Si se cuenta como IA, GPTZero sube del 41,9 % al 75,7 % en texto actual sin editar y del 2,0 % al 62,0 % en paráfrasis actual, sin que cambien sus cero falsos positivos. Las tablas de arriba solo usan su etiqueta segura "ai".
¿Pueden los detectores de IA detectar texto de GPT-5.6?
En parte. Con la salida sin editar de GPT-5.6, GPTZero se quedó entre el 43 y el 57 % según la variante (Sol 57 %, Luna 56 %, Terra 43 %), ZeroGPT entre el 21 y el 29 % y tropa-2 en el 100 %. La salida parafraseada de GPT-5.6 es mucho más difícil para todas las herramientas.
¿Dan falsos positivos los detectores de IA con redacciones de estudiantes?
Sí, y es la cifra que hay que vigilar. En los 59 ensayos de PERSUADE de esta prueba, ni GPTZero ni ZeroGPT ni tropa-2 acusaron a ninguno. En una ejecución más amplia con 3.000 ensayos de PERSUADE, tropa-2 acusó al 2,6 %. El veredicto de un detector nunca debería ser la única prueba en un caso de integridad académica.
¿Por qué el texto de IA parafraseado puntúa más bajo que el texto de IA sin editar?
Parafrasear ancla la salida a la estructura, el vocabulario y el orden argumental de un documento humano, así que buena parte de la señal en la que se fija un detector la hereda de una persona. Es el mayor punto débil de esta comparativa: GPTZero 2,0 %, ZeroGPT 2,1 % y tropa-2 74,0 % en paráfrasis de modelos actuales, frente al 96,3 % en texto sin editar.
Analiza un documento tú mismo
Pégalo en WasItAIGenerated. Los análisis ya funcionan con tropa-3, nuestro modelo actual.
Prueba tropa-3 gratis